
강화학습이 뭐길래 로봇이 스스로 걷는 법을 배우나요?
로봇에게 "이렇게 걸어라"를 하나하나 가르치지 않아도, 시도해 보고 점수를 매기는 것만으로 걷는 법을 스스로 찾아내는 방법이 있습니다. 강화학습을 쉬운 비유로 설명하고, 저희가 실제로 K1 로봇에 적용한 결과로 이어집니다.
로봇에게 "이렇게 걸어라"를 하나하나 가르치지 않습니다. 대신 잘하면 점수를 주고, 그 점수를 보고 로봇이 스스로 방법을 찾게 합니다. 이 방식을 강화학습(reinforcement learning)이라고 부릅니다.
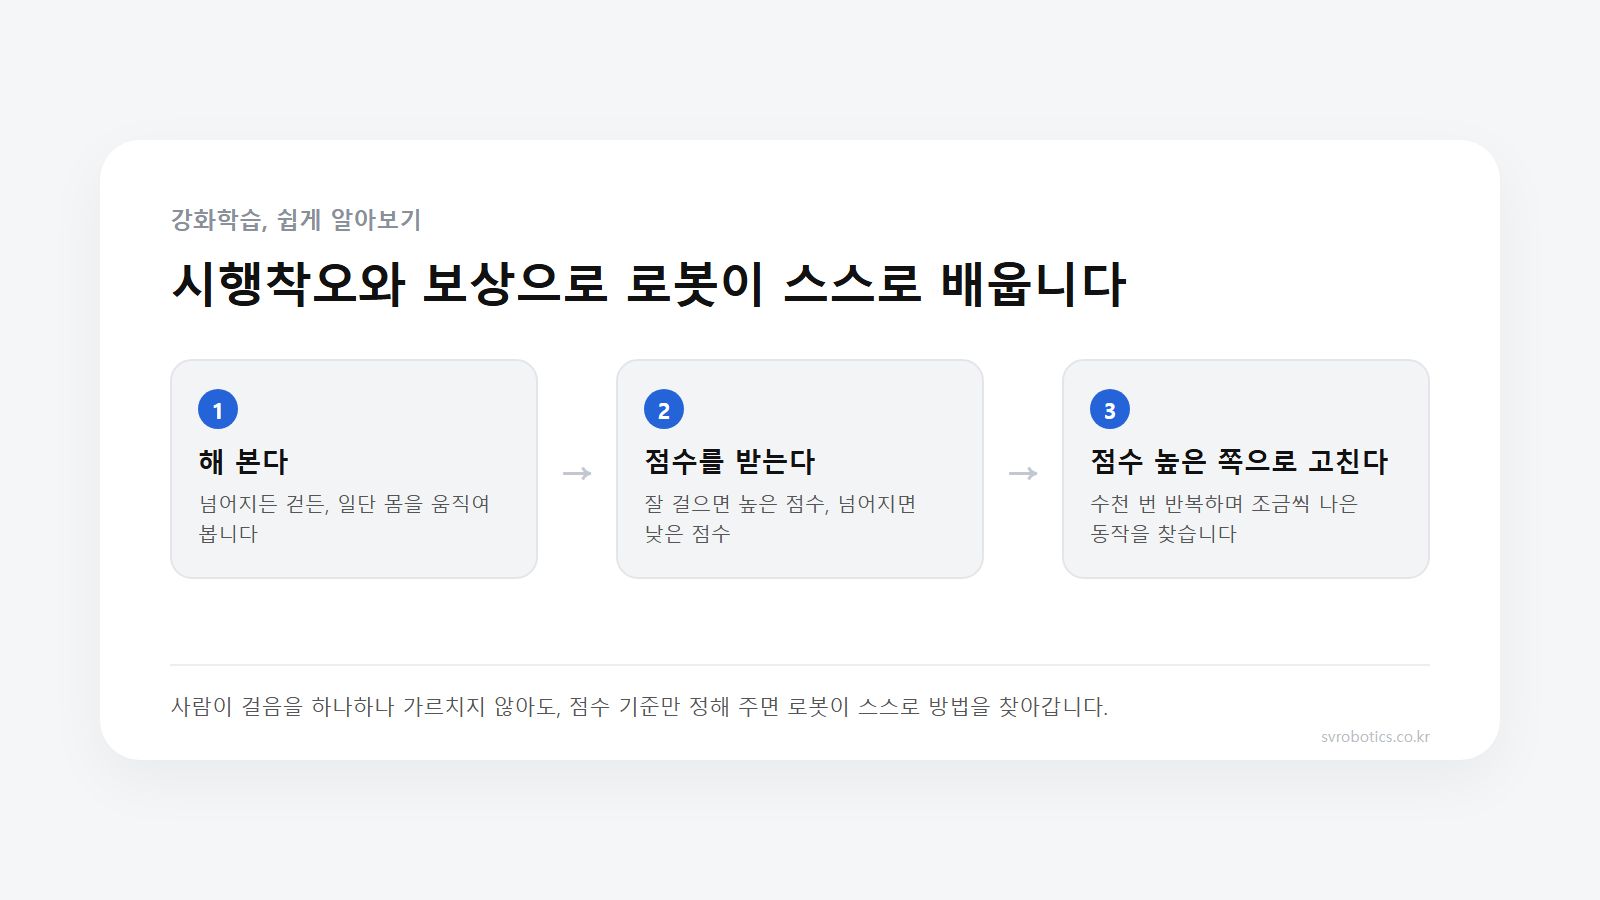
저희는 이 방식으로 실제 휴머노이드 로봇 Booster K1이 걷는 법을 시뮬레이션 안에서 학습시켰습니다. 이 글은 그 원리를 기술 배경 없이도 이해할 수 있게 풀어 쓴 것입니다.
강아지 훈련과 비슷합니다
"앉아"를 말로 설명하는 대신, 앉을 때마다 간식을 주는 방법을 떠올려 보십시오. 강아지는 왜 앉아야 하는지 이해하지 못해도, 간식(보상)을 더 많이 받는 행동을 점점 더 자주 하게 됩니다.
강화학습도 같은 원리입니다. 로봇에게 "다리를 이렇게 굽히고 저렇게 펴라"는 동작 하나하나를 가르치는 대신, 잘 걸으면 점수(보상)를 주는 기준만 정해 주고, 로봇이 수많은 시도 끝에 점수가 높아지는 방향을 스스로 찾게 합니다.
세 단계로 반복합니다
해 본다 → 점수를 받는다 → 점수가 높은 쪽으로 조금 고친다. 이 세 단계를 아주 많이 반복하는 것이 전부입니다.
- 해 본다 — 처음에는 아무렇게나 몸을 움직여 봅니다. 대부분 넘어집니다
- 점수를 받는다 — 오래 서 있었는지, 앞으로 나아갔는지, 넘어졌는지에 따라 점수가 매겨집니다
- 점수 높은 쪽으로 고친다 — 점수가 조금이라도 높았던 시도의 방식을 다음 시도에 더 많이 반영합니다
저희가 K1 로봇을 학습시킬 때는 이 세 단계를 컴퓨터 안에서 한 번에 4,096대를 동시에, 수천 번 반복했습니다. 사람이 하나씩 가르쳤다면 불가능했을 속도입니다.
왜 시뮬레이션 안에서 하나요?
실제 로봇으로 수천 번 넘어뜨리며 시도할 수는 없기 때문입니다. 넘어질 때마다 부품이 상하고 시간도 오래 걸립니다. 컴퓨터 안의 가상 로봇으로는 넘어져도 다치지 않고, 여러 대를 동시에 돌려 짧은 시간에 수천 번을 시도할 수 있습니다.
저희는 Isaac Sim이라는 시뮬레이터 위에서 Booster K1의 가상 모델을 만들어 이 방식으로 학습시켰습니다. 실제로 GPU 한 장이 달린 PC로 32분 만에 넘어지지 않고 걷는 로봇을 만들 수 있었습니다.
"점수 기준을 어떻게 정하느냐"가 왜 중요한가요?
점수 기준이 이상하면 로봇도 이상한 방법을 찾기 때문입니다. 저희가 처음 만든 점수 기준은 "넘어지지 않고 앞으로 나아가면 점수"였는데, 그 결과 로봇은 1초에 발을 15번 넘게 딛는 종종걸음으로 걸었습니다. 점수 기준에 걸음 모양에 대한 항목이 없었기 때문입니다.
걸음 모양에도 점수를 주도록 기준을 다시 정하자, 1초에 3~4번 딛는 사람에 가까운 걸음으로 바뀌었습니다. 강화학습에서 가장 어려운 일은 로봇을 움직이는 것이 아니라, "무엇을 잘한 것으로 칠지" 점수 기준을 잘 만드는 일입니다.
자주 묻는 질문
로봇이 스스로 생각해서 걷는 건가요?
아닙니다. 로봇은 "생각"하지 않습니다. 수많은 시도와 점수의 결과로, 점수가 높았던 동작 패턴을 더 자주 선택하도록 계산 방식이 조정될 뿐입니다.
사람이 할 일은 없나요?
있습니다. 어떤 행동에 점수를 얼마나 줄지 정하는 것(점수 기준 설계)은 사람이 합니다. 이 기준을 어떻게 짜느냐에 따라 결과가 크게 달라집니다.
시뮬레이션에서 잘 걸으면 실제 로봇에서도 바로 걷나요?
보장되지 않습니다. 시뮬레이션과 실제 물리는 차이가 있어, 다른 시뮬레이터로 옮겨 보거나 실제 로봇에서 다시 확인하는 절차가 필요합니다. 저희도 이 부분을 저희 연재의 다른 글에서 확인했습니다.
이런 학습을 하려면 비싼 장비가 필요한가요?
저희는 GPU 한 장이 달린 일반 PC 한 대로 진행했습니다. 자세한 사양과 걸린 시간은 아래 연재에 정리해 두었습니다.
다음 단계
이 원리를 실제 휴머노이드 로봇 K1에 적용한 전체 과정 — 설치부터 첫 학습, 걸음 모양 개선, 다른 시뮬레이터로 확인하기까지 — 은 저희 연재 "피지컬 AI, 직접 해 봤습니다"에 그대로 공개돼 있습니다.
출처: 저희 K1 걷기 강화학습 연재(2026-09-10~23). 비유와 설명은 이해를 돕기 위한 것이며, 정확한 수치와 절차는 연재 각 편에 있습니다.
이 글과 그림의 저작권은 SV로보틱스에 있습니다. 원문 링크를 밝힌 인용은 환영하며, 전문 복제·재배포와 교육 자료로의 전재는 허락이 필요합니다.